Robots.txt e noindex: controles diferentes para objetivos diferentes
Diferencie regras de rastreamento e diretivas de indexação e evite usar robots.txt como proteção para conteúdo privado.
Redação Lignet Brasil · 16/10/2026 · Atualizado em 16/10/2026
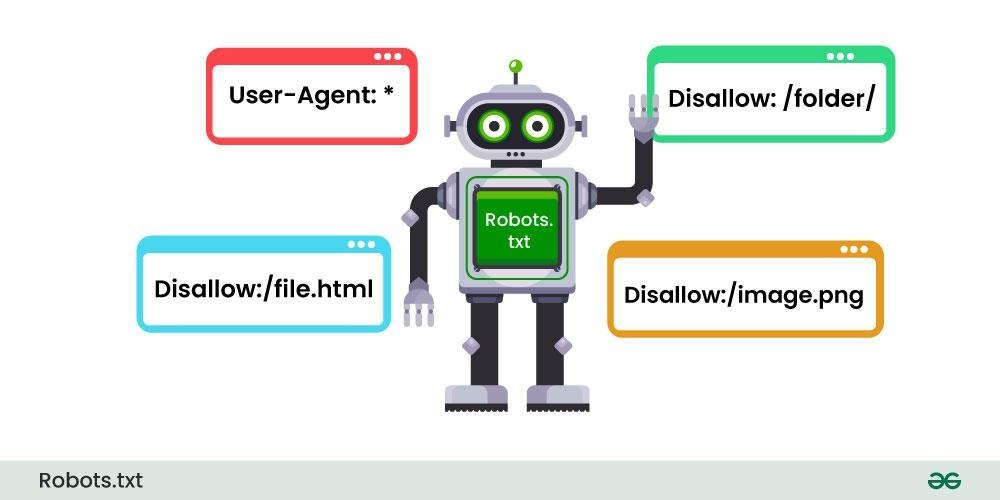
O arquivo robots.txt oferece instruções de rastreamento para robôs que seguem o protocolo. Ele não funciona como autenticação e não impede que uma pessoa acesse uma URL conhecida. Informações privadas precisam de controles de acesso no servidor.
Uma regra Disallow pode impedir que um robô compatível busque o conteúdo de um caminho. Isso não equivale necessariamente a remover o endereço dos resultados de busca. Um mecanismo pode conhecer a URL por outros links, mesmo sem poder ler a página.
A diretiva noindex tem outro objetivo: indicar que o conteúdo não deve ser indexado pelos mecanismos que a respeitam. Para que uma diretiva na página seja lida, o robô precisa conseguir acessar essa resposta. Bloquear o rastreamento e esperar que ele descubra uma metatag nova pode produzir um resultado diferente do desejado.
Use cabeçalhos ou metatags adequados ao tipo de recurso e valide a resposta real. Páginas de conta, relatórios privados e painéis administrativos devem depender principalmente de autenticação e autorização. Não coloque segredos em caminhos que você espera esconder apenas com regras de robô.
Ao revisar uma configuração, separe os objetivos: limitar rastreamento, evitar indexação e restringir acesso são tarefas distintas. A ferramenta de robots.txt da Lignet ajuda a montar o arquivo, mas não decide quais regras são corretas para o seu negócio. Teste mudanças cuidadosamente e acompanhe o comportamento com as ferramentas do buscador, sem esperar remoção imediata.
Referências para conferir
- https://developers.google.com/search/docs/crawling-indexing/robots/intro
- https://developers.google.com/search/docs/crawling-indexing/block-indexing
Documentações podem mudar. Confira a versão do software e as condições do seu ambiente antes de aplicar alterações.